数据治理不必先做完,边用边治,越用越准
物业公司的数据,问题只有用起来才看得见。FMClaw™ 行业数据本体让治理和使用同时发生:先接进来用起来,不好用当场调,调整成本低。
- 不换现有系统
- 接入后约 72 小时可用
- 一处改、处处生效
先治理、再应用,为什么常常收不了场
很多物业集团的想法是:先找一个很强的团队把数据治理好,再来做业务。问题在于,治理的对错,只有业务用起来才知道。
- 01
找一个很强的团队,先把数据治理好
梳理系统、统一字段、建数仓,一做就是一年半载;这段时间里,业务照旧靠人工报表。
- 02
治理完,交给业务去用
做治理的人往往不懂物业业务:收缴率按什么算、空置房算不算应收、抬杆放行算不算漏收费,这些定义藏在一线的习惯里,不在系统字段里。
- 03
用起来不好用,再回去返工
口径对不上、关键数据缺字段、报表没人看。返工意味着重新立项、重新梳理,到这一步,项目基本就收不了场了。这是很多物业集团 CTO 的核心痛点。
不能先知后行,也不能先行后知
先治理、后使用,是先知后行:定义脱离业务,做完才发现不对。先上应用、不管数据,是先行后知:答得快,但口径打架、没人敢信。两种都会出问题。
治理和使用只能同时发生,这才是知行合一
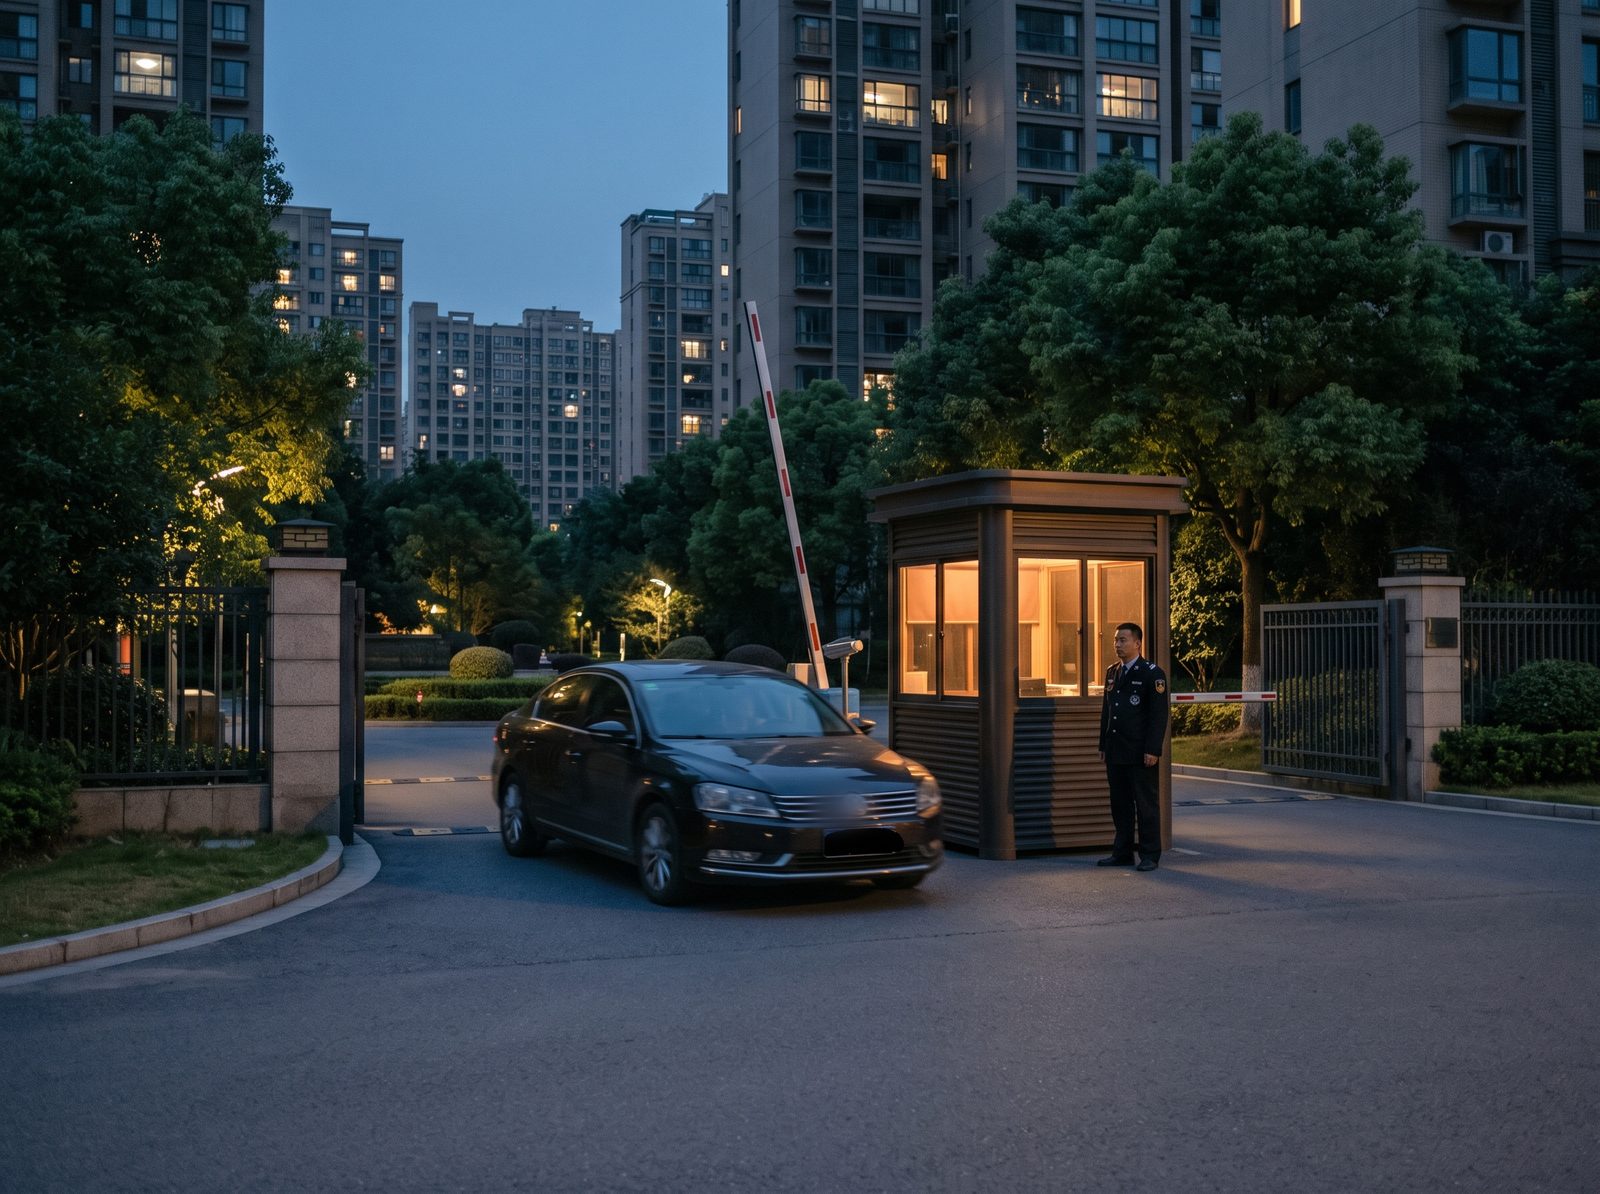
4 套停车系统,只有 1 套数据全
一个每家集团都会遇到的例子:集团想知道各项目的抬杆放行率,也就是停车漏收费。下面是边用边治的做法。
- 01
接进来,先用起来
连接器接入已有的收费、停车、门禁、工单等系统,不换系统、不先做清洗,接入后通常 72 小时内可调用。
- 02
问题在使用中自己暴露
第一次问「各项目停车漏收费」,才发现 4 套停车系统里只有 1 套记录了完整的放行与缴费。不用,就永远不知道缺的是哪一块。
- 03
在数据本体里调整,而不是重新立项
在完整的那 1 套上先把抬杆放行率的口径定下来;另外 3 套标为「未覆盖」,缺哪些字段、在哪些项目,列成升级清单。改的是本体里的定义,一处改、处处生效。
- 04
补齐一套,覆盖一套
某套停车系统升级后,口径自动覆盖过去;报告、问数和考核用的始终是同一个数。治理的范围,跟着业务真正用到的地方扩展。
数据本体,是让「边用边改」成本低的那一层
本体统一描述项目、空间、设备、人员、工单、合同等业务对象与关系,以及指标口径、服务标准和权限。改口径,是改这一层的一条定义,而不是改十几个系统、重做一遍数仓。

边用边治,但这三件事第一天就要定好
权限与项目隔离
谁能看哪个项目、智能体能读哪些数据,第一天就按组织架构定好,不留到以后。
集团核心口径确认一次
收缴率这类要跨项目比较的指标,集团口径需要集团层面确认一次。其余口径可以在使用中逐步收敛。
每一次调整都有记录
口径何时改、谁改的、影响哪些报告,有记录可查,调整成本低,但不随意。
关于物业数据治理,你可能想问
- 物业公司做数据治理,一定要先治理完再上应用吗?
- 不必,也不建议。治理的对错只有业务用起来才知道:先治理一年再上应用,常见的结果是做完不好用、再返工。FMClaw™ 采用先接进来用起来、边用边治理的做法,问题在使用中暴露,当场在数据本体里调整,一处改、处处生效。
- 传统数据治理项目为什么容易失败?
- 最常见的原因是做治理的人不懂物业业务。收缴率怎么算、空置房算不算应收、抬杆放行算不算漏收费,这些定义藏在一线的业务习惯里,不在系统字段里。脱离使用做出来的治理,交给业务时往往对不上,再返工的成本很高。
- 什么是边用边治?会不会越用越乱?
- 边用边治,是让治理和使用同时发生:数据先接入、先在业务里用,发现的口径冲突和数据缺口,在数据本体里调整定义。不会越用越乱,因为有三件事第一天就定好:权限与项目隔离、集团核心口径确认一次、每次调整有记录。
- 多套系统数据不全,比如 4 套停车系统只有 1 套完整,怎么治理?
- 先在数据完整的那套系统上把抬杆放行率等口径定下来并用起来,其余系统标为未覆盖,缺哪些字段、在哪些项目列成升级清单。某套系统升级后,口径自动覆盖过去,报告、问数和考核用的始终是同一个数。
- 行业数据本体和数据中台、主数据管理是什么关系?
- 不替换,也不重建。已有的数据中台、IoT 中台和业务系统通过连接器接入,数据本体在其之上统一业务对象与关系、指标口径、服务标准和权限,让 AI 读得懂这些数据,并把调整的成本降到改一条定义。
- 数据治理要多久能看到效果?
- 接入后通常 72 小时内数据即可被调用,第一份自动报告或第一次问数就能暴露问题。治理范围随业务用到的地方逐步扩展,而不是等全部治理完再看效果。
带一个口径打架的指标来,
当场边用边治一次
收缴率、漏收费都可以。看问题在哪暴露、怎么调、调完谁跟着变。
治理好的数据怎么被问,见 物业智能问数 · 产品能力见 行业数据本体与指标中心 · 落地案例见 百强物业集团